 X-Dreamers
我们如何制作实验室
我们怎样决定画什么、怎样标明有多确定、资料从哪里来、怎样呈现不同的看法,以及发现错误时怎样告诉我们。
五个证据等级
每个实验室里的每一项说法,都标有下面五个等级之一。等级看的是证据,不是我们喜不喜欢某个说法。
- 经文明言
- 圣经白纸黑字写着,我们把经文引出来。
- 有力支持
- 由经文紧密推论而来,或有确实的证据支持,例如出土的遗址或碑文。
- 合理推测
- 几种都说得通的复原中,合理的一种。其他几种是什么,我们也会说明。
- 推测
- 有根据的猜想。经文没有说,证据也很少或只是间接的。
- 艺术呈现
- 为了能把场景画出来而作的风格选择:人物的脸、颜色、光线、人群。
我们怎样复原
一切从经文开始。圣经给出的尺寸、材料、数目和地点,照原样以肘为单位画出,比例也一定标明。
经文没有说的,我们找最接近的证据:先看同一时期、同一地区出土的建筑和器物,再看约瑟夫、《密西拿》这类较晚的记载,并注明它们比经文晚。如果什么都没有,就选最简单、说得通的样子,标为“推测”或“艺术呈现”。
- 从不描绘神的形象。云彩、火和荣耀,只用光克制地表现。
- 模型和图画都是手工或用程序做的,不使用 AI 生成的图像。
- 经文容许不止一种样子时,实验室会说明画的是哪一种、为什么;能切换的地方,也让你自己切换。
“今天”和“复原”一定分开标明
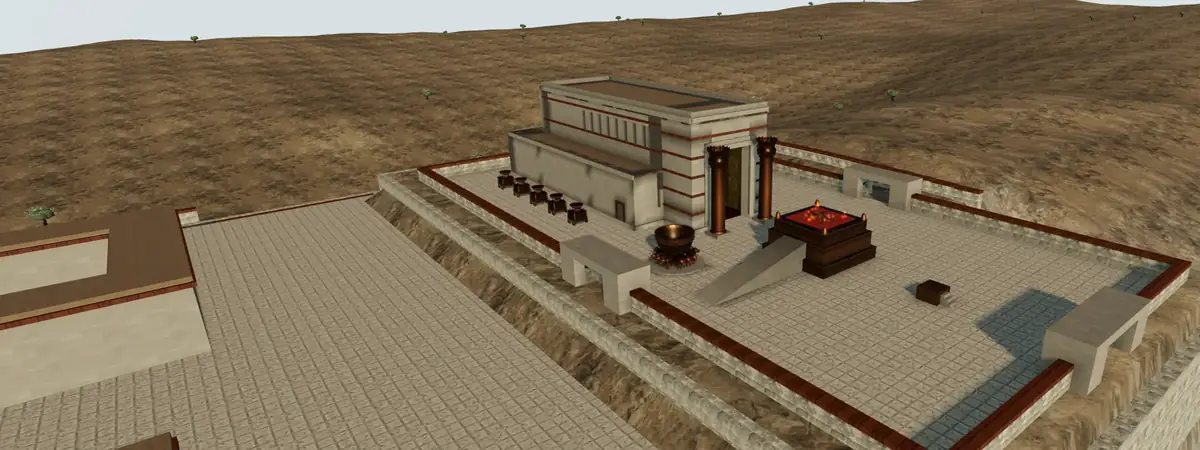
遗址今天的照片标为“今天”;推想当年样貌的图,标为复原,并注明年代。两者不会不加标示地混在同一张图里,让你一眼分得出哪些是看得到的,哪些是推想的。
我们怎样选择资料
经文只引用两个译本:英文的英王钦定本(1769)和中文的 1919 年和合本(公有领域)。经文由我们自己的文本流程导入,从不手工重打。
经文以外的事实,我们依次优先采用:考古发掘报告和实际主持发掘的考古学家(Kenyon、Mazar、Reich 与 Shukron 等,各实验室都具名列出);公认的参考书和开放资料,例如 Pleiades、OpenBible;较早的公有领域百科和注释书,并注明年代;一般性的参考条目只作入门,用到时一定列出。圣经以外的古代作者,例如约瑟夫,我们引用他们的说法,并注明比经文晚。
每个实验室最后都有“资料来源与限制”一段,列出所有资料,并老实说明这个实验室做不到什么。
我们怎样呈现不同的看法
认真读经的人看法不同的地方,例如西奈山在哪里、以色列人从哪里过海、圣殿建在山上的哪个位置、耶稣在哪里受审,我们把几种看法并排列出。每一种都写明谁持这个看法,以及支持和反对的证据。我们不替读者下结论。
可是 3D 场景总得画出一种。画的时候,证据说明会讲清楚模型画的是哪一种,并注明这是绘图上的选择,不是定论。我们收录有学者公开论证的看法,没有人认真主张的说法则不收。
经文异文与译本差异
古抄本和译本有时不一样,常常是在数字上:历代志下 3:4 所罗门圣殿的廊,希伯来文作高一百二十肘,一份重要的希腊文抄本作二十肘;列王纪和历代志说铜海可容二千和三千罢特。我们把 KJV 和和合本实际的读法并排引出;其他版本的读法,只有在能注明出处时才列出。无法从可引用的资料核实的异文,我们一概不收。
每个实验室怎样把关
每个实验室或每次修改发布之前:
- 每次发布都会自动检查:每处经文出处都必须在我们引用的经文里找得到;每项说法都必须标明等级;每种不同看法都必须列出正反两面的证据;每项资料都必须能正常显示。
- 团队用中英文把整个实验室读一遍,并对照它所引用的资料。
- 我们在电脑和手机上、用中英文各检查一次。
我们怎样使用 AI 工具
这一点我们老实交代:AI 工具帮我们写程序、起草文字,但不由它决定什么是对的。每项说法都对照页面上列出的资料核对过;经文只透过我们自己的流程引用 KJV 和 1919 年和合本,从不由 AI 生成。实验室里没有 AI 生成的图像,也没有任何功能会把你的问题或资料送到 AI 服务。
实验室由十字架梦想家(X-Dreamers)的一个小团队制作,目前还没有经过外部学者审阅。所以下面一段暂时是空的。
审阅学者
目前还没有具名的外部审阅者。将来有学者审阅某个实验室并同意具名,他们的名字、审阅的内容和时间会列在这里,也会显示在该实验室上。
已有完整证据说明的实验室
这些实验室在 3D 或地图下方都有“我们有多确定?”和“资料来源与限制”。其他实验室会逐一加上。