 X-Dreamers
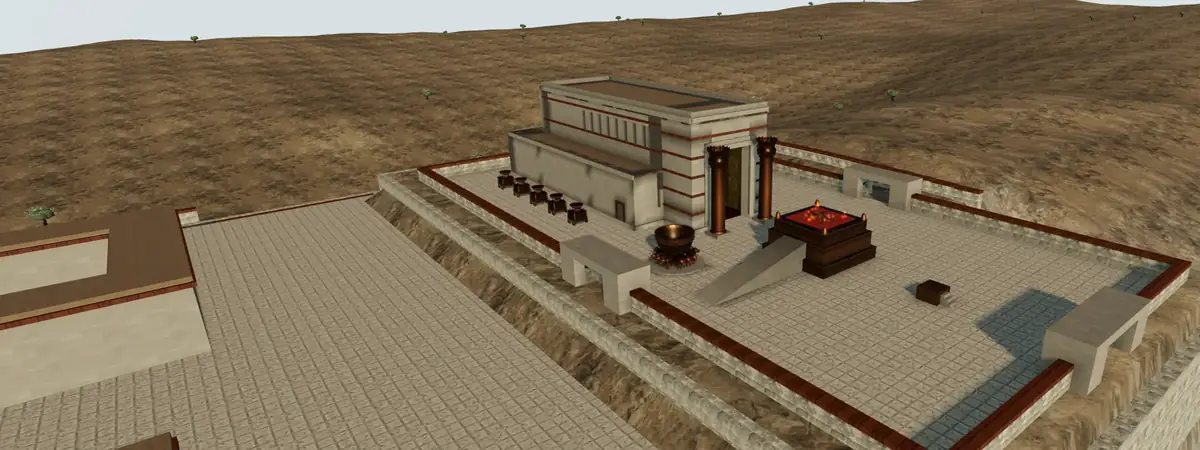
我們如何製作實驗室
我們怎樣決定畫什麼、怎樣標明有多確定、資料從哪裡來、怎樣呈現不同的看法,以及發現錯誤時怎樣告訴我們。
五個證據等級
每個實驗室裡的每一項說法,都標有下面五個等級之一。等級看的是證據,不是我們喜不喜歡某個說法。
- 經文明言
- 聖經白紙黑字寫著,我們把經文引出來。
- 有力支持
- 由經文緊密推論而來,或有確實的證據支持,例如出土的遺址或碑文。
- 合理推測
- 幾種都說得通的復原中,合理的一種。其他幾種是什麼,我們也會說明。
- 推測
- 有根據的猜想。經文沒有說,證據也很少或只是間接的。
- 藝術呈現
- 為了能把場景畫出來而作的風格選擇:人物的臉、顏色、光線、人群。
我們怎樣復原
一切從經文開始。聖經給出的尺寸、材料、數目和地點,照原樣以肘為單位畫出,比例也一定標明。
經文沒有說的,我們找最接近的證據:先看同一時期、同一地區出土的建築和器物,再看約瑟夫、《密西拿》這類較晚的記載,並註明它們比經文晚。如果什麼都沒有,就選最簡單、說得通的樣子,標為「推測」或「藝術呈現」。
- 從不描繪神的形象。雲彩、火和榮耀,只用光克制地表現。
- 模型和圖畫都是手工或用程式做的,不使用 AI 生成的圖像。
- 經文容許不止一種樣子時,實驗室會說明畫的是哪一種、為什麼;能切換的地方,也讓你自己切換。
「今天」和「復原」一定分開標明
遺址今天的照片標為「今天」;推想當年樣貌的圖,標為復原,並註明年代。兩者不會不加標示地混在同一張圖裡,讓你一眼分得出哪些是看得到的,哪些是推想的。
我們怎樣選擇資料
經文只引用兩個譯本:英文的英王欽定本(1769)和中文的 1919 年和合本(公有領域)。經文由我們自己的文本流程導入,從不手工重打。
經文以外的事實,我們依次優先採用:考古發掘報告和實際主持發掘的考古學家(Kenyon、Mazar、Reich 與 Shukron 等,各實驗室都具名列出);公認的參考書和開放資料,例如 Pleiades、OpenBible;較早的公有領域百科和註釋書,並註明年代;一般性的參考條目只作入門,用到時一定列出。聖經以外的古代作者,例如約瑟夫,我們引用他們的說法,並註明比經文晚。
每個實驗室最後都有「資料來源與限制」一段,列出所有資料,並老實說明這個實驗室做不到什麼。
我們怎樣呈現不同的看法
認真讀經的人看法不同的地方,例如西奈山在哪裡、以色列人從哪裡過海、聖殿建在山上的哪個位置、耶穌在哪裡受審,我們把幾種看法並排列出。每一種都寫明誰持這個看法,以及支持和反對的證據。我們不替讀者下結論。
可是 3D 場景總得畫出一種。畫的時候,證據說明會講清楚模型畫的是哪一種,並註明這是繪圖上的選擇,不是定論。我們收錄有學者公開論證的看法,沒有人認真主張的說法則不收。
經文異文與譯本差異
古抄本和譯本有時不一樣,常常是在數字上:歷代志下 3:4 所羅門聖殿的廊,希伯來文作高一百二十肘,一份重要的希臘文抄本作二十肘;列王紀和歷代志說銅海可容二千和三千罷特。我們把 KJV 和和合本實際的讀法並排引出;其他版本的讀法,只有在能註明出處時才列出。無法從可引用的資料核實的異文,我們一概不收。
每個實驗室怎樣把關
每個實驗室或每次修改發布之前:
- 每次發布都會自動檢查:每處經文出處都必須在我們引用的經文裡找得到;每項說法都必須標明等級;每種不同看法都必須列出正反兩面的證據;每項資料都必須能正常顯示。
- 團隊用中英文把整個實驗室讀一遍,並對照它所引用的資料。
- 我們在電腦和手機上、用中英文各檢查一次。
我們怎樣使用 AI 工具
這一點我們老實交代:AI 工具幫我們寫程式、起草文字,但不由它決定什麼是對的。每項說法都對照頁面上列出的資料核對過;經文只透過我們自己的流程引用 KJV 和 1919 年和合本,從不由 AI 生成。實驗室裡沒有 AI 生成的圖像,也沒有任何功能會把你的問題或資料送到 AI 服務。
實驗室由十字架夢想家(X-Dreamers)的一個小團隊製作,目前還沒有經過外部學者審閱。所以下面一段暫時是空的。
審閱學者
目前還沒有具名的外部審閱者。將來有學者審閱某個實驗室並同意具名,他們的名字、審閱的內容和時間會列在這裡,也會顯示在該實驗室上。
已有完整證據說明的實驗室
這些實驗室在 3D 或地圖下方都有「我們有多確定?」和「資料來源與限制」。其他實驗室會逐一加上。